ViT에 깊이(Depth)를 더하면? RGB-D Depth ViT를 ImageNet-1K로 처음부터 학습한 기록
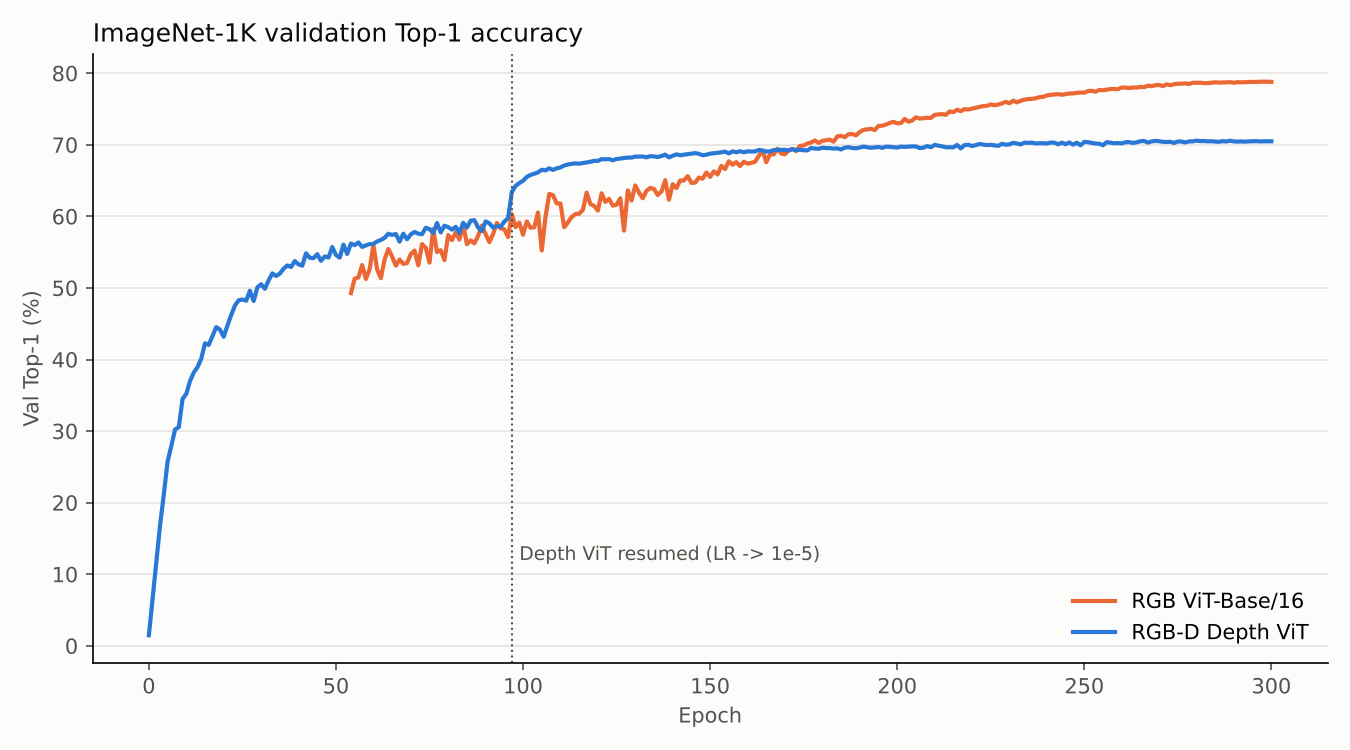
먼저 짚고 갈 점. 이 글의 "Depth ViT"는 3D 볼륨(복셀, 비디오)을 넣는 ViT가 아니라, RGB 3채널에 깊이(Depth) 1채널을 붙인 4채널 입력의 ViT입니다. VLM(Vision Language Model)의 시각 인코더로 쓸 ViT를 직접 만들면서 "RGB에 깊이를 더하면 공간 이해가 좋아질까?"라는 가설을 세웠습니다.그 첫 단계로 RGB ViT와 RGB-D ViT를 같은 ImageNet-1K로 각각 처음부터 학습했습니다.모든 수치는 저장소의 커밋과 logs/depth_vit/, logs/imagenet_vit/ 학습 로그에서 직접 읽은 값입니다.한눈에 보기RGB ViT-Base/16은 최고 78.82%, RGB-D Depth ViT는 최고 70.58%(Val Top-1)였습니다...